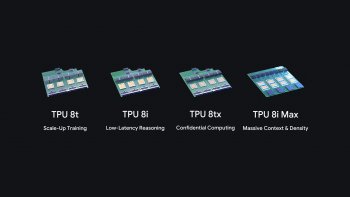
Google anunció la expansión de su portfolio de TPU de octava generación con dos sistemas adicionales, TPU 8tx y TPU 8i Max, especializados en IA segura y de alto contexto. Es la primera vez que la empresa introduce cuatro configuraciones de TPU en un solo año, según el anuncio del 9 de noviembre de 2026.
Las TPU se emplean para entrenar y ejecutar los modelos Gemini de Google, para prestar servicios a clientes de Google Cloud dentro de su infraestructura y, más recientemente, para que los clientes las implementen directamente en sus propios centros de datos. Ese último uso ha convertido a las TPU en un negocio en rápida expansión, con cerca de 100 clientes, entre ellos laboratorios de vanguardia, firmas de trading, empresas minoristas y universidades.
Los TPU 8t y TPU 8i, anunciados por primera vez en Cloud Next en abril de 2026, establecieron el punto de referencia de esta generación: ofrecen, respectivamente, un rendimiento de entrenamiento hasta 2,7 veces superior y una relación precio-rendimiento en inferencia un 80 % mejor en comparación con las generaciones anteriores de TPU. La TPU 8t fue diseñada como potencia de entrenamiento para modelos fundacionales masivos, mientras que la TPU 8i funciona como motor de razonamiento para reducir hasta a la mitad los retardos en la comunicación entre chips.
Amin Vahdat, Chief Technologist and Senior Vice President for AI and Infrastructure at Google, señaló que, a medida que la computación pasa de una escala centrada en el ser humano a una basada en agentes, las empresas demandan aceleradores capaces de razonar a través de enormes ventanas de contexto, y que algunos clientes de sectores altamente regulados solicitan capacidades de cifrado especializadas. Vahdat añadió que estos nuevos sistemas TPU responden a esa realidad y que, junto con los recientes anuncios sobre PyTorch, el objetivo es hacer las TPU más accesibles para desarrolladores y clientes.
La TPU 8tx está dirigida a empresas reguladas y gobiernos que ejecutan modelos de vanguardia o propietarios y agentes autónomos con datos confidenciales. Desarrollada sobre el mismo silicio que la TPU 8t y combinada con hosts basados en CPU AMD personalizados, integra la seguridad en la capa de hardware para mantener protegidos y aislados los datos y los pesos de los modelos incluso durante su uso activo. Con la red Boardfly de baja latencia, ofrece una latencia dos veces menor que la del TPU 8t, prácticamente sin penalización en el rendimiento, y permite ajustar modelos con datos privados, destilar modelos grandes en otros más pequeños y entrenar agentes mediante aprendizaje por refuerzo sin migrar datos entre clústeres.
La TPU 8i Max combina dos chips TPU 8i de baja latencia en un único encapsulado para escalar de forma sincronizada la capacidad de cómputo y la memoria. Frente al TPU 8i, ofrece el doble de capacidad de cómputo, el doble de memoria SRAM y el doble de ancho de banda de memoria HBM, además del doble de densidad de rendimiento por rack. Con las cuatro configuraciones, Google busca cubrir cada etapa del ciclo de vida de los agentes: la TPU 8t para el entrenamiento a gran escala, la TPU 8i para el razonamiento de baja latencia, la TPU 8tx para la computación confidencial y la TPU 8i Max para ventanas de contexto masivas y la mayor densidad de cómputo por rack.
Google amplía su octava generación de TPU con TPU 8tx y TPU 8i Max para agentes de IA
Recibe las noticias de NTCD en tu correo
Una selección de actualidad, nacional, ciudad, economía, deportes, tecnología y más. Sin costo.
Al registrarte aceptas recibir el boletín. Puedes darte de baja cuando quieras. Consulta nuestro aviso de privacidad.Te podría interesar
Tecnología
Sovos adquiere Flowie y presenta una plataforma de finanzas con agentes de IA y cumplimiento fiscal
Sovos anunció la adquisición de Flowie, plataforma de orquestación de finanzas basada en agentes de inteligencia artificial,…
Tecnología
Google presenta herramientas de Gemini para pequeñas empresas
Google anunció nuevas herramientas en Gemini orientadas a los propietarios de pequeñas empresas, con las que busca simplific…
Tecnología
Google Cloud integra modelos de OpenAI en su catálogo Model Garden
Google Cloud incorporó los modelos de OpenAI a su catálogo Model Garden, con lo que se convierte, según su anuncio, en el ún…
Tecnología
Palo Alto Networks presenta Cortex XDR One para vigilar agentes de IA en dispositivos empresariales
Palo Alto Networks dio a conocer Cortex XDR One, una plataforma que integra detección y respuesta extendida con seguridad es…
Tecnología
GlobalLogic presenta TAK, una herramienta de IA agéntica para validar banda ancha y 5G FWA
GlobalLogic, compañía del Grupo Hitachi, desarrolló Test Automation Kit (TAK), un framework de automatización de pruebas bas…
Tecnología
Centro Público de Formación en IA inicia segunda generación con 23 mil jóvenes
El Centro Público de Formación en Inteligencia Artificial dio inicio a su segunda generación, integrada por 23 mil jóvenes,…